课程背景
在AIGC技术爆发的当下,企业对私有化大模型应用的需求日益增长。Dify作为开源的LLM应用开发平台,以其强大的工作流编排、RAG(检索增强生成)能力和灵活的私有化部署方案,成为企业构建AI中台的首选工具。
本课程基于Dify平台,深入解析“规划-工具-记忆-行动”的智能体核心架构,结合企业实际痛点,从零开始讲解Dify的私有化部署(Docker/WSL2)、知识库构建、Agent开发及工作流(Workflow)编排。课程通过“患者模拟器”、“新生入学指南”、“读书卡片生成器”、“Text2SQL数据分析”等实战案例,帮助学员掌握从环境搭建到复杂应用落地的全流程技能,助力企业实现数据安全可控的智能化转型。
课程收益
深度认知 解析AI智能体架构,理解Dify在企业私有化部署、数据安全及LLMOps中的核心价值。
环境搭建 掌握Dify的本地化部署(Docker/WSL2)、模型接入(Ollama/SiliconFlow)及基础配置。
核心技能 精通Prompt工程、Markdown脚本编写,掌握RAG知识库的数据清洗、分段与混合检索策略。
高阶应用 掌握Workflow工作流编排,运用Text2SQL实现数据库交互,开发复杂业务场景的智能体。
实战落地 通过四大实战案例,独立完成从需求分析、流程设计到应用发布的全过程,具备企业级AI应用开发能力。
课程赠品:
Dify本地部署保姆级教程文档
实战案例DSL文件包(患者模拟器、面试宝典、读书卡片)
企业级Prompt提示词模板库
Text2SQL配置与MySQL连接指南
课程基本信息:
课程时间:2天(6小时/天)
课程对象:企业IT技术人员、产品经理、数字化转型负责人、AI应用开发者
课程方式:理论讲解 + 案例演示 + 实操演练 + 互动答疑
课程工具:Dify、Docker、Ollama/SiliconFlow、MySQL、Markdown
第一讲:Dify认知与部署——构建企业私有化AI中台
本模块重点解决Dify“是什么”和“怎么装”的问题,通过对比SaaS平台(如Coze),阐述Dify在数据隐私和定制化方面的优势,并手把手指导学员完成本地环境搭建。
1.1 AI Agent与Dify平台全景解析
AI Agent核心架构:规划(Planning)、工具(Tools)、记忆(Memory)、行动(Action)
Dify平台核心优势:开源生态、LLMOps全生命周期管理、数据隐私安全
Dify vs Coze/GPTs:私有化部署与企业级集成的差异分析
应用类型解析:聊天助手(Chat)、智能体(Agent)、工作流(Workflow)
1.2 Dify私有化部署实战(Windows/Linux)
基础环境准备:WSL2(Windows Subsystem for Linux)配置与优化
容器化技术入门:Docker Desktop安装与镜像加速配置
Dify一键部署:Git Clone源码、.env配置、Docker Compose启动
常见问题排查:端口冲突、镜像拉取失败、Redis/DB连接异常
1.3 模型接入与基础配置
模型供应商接入:SiliconFlow(硅基流动)、DeepSeek、ZhipuAI API配置
本地模型接入:Ollama安装与Llama3/Qwen模型加载
系统基础设置:管理员账户配置、界面语言与工作区管理
1.4 实战案例:我的第一个对话机器人
场景:创建“患者模拟器”Agent,用于医生问诊考核
Prompt工程:角色设定(Role)、任务目标(Goals)、回复约束(Constraints)
调试与发布:预览窗口调试、日志查看、Web应用发布
⚔️ 课堂演练:搭建一个“各种不服”的模拟辩论对手
第二讲:RAG知识库实战——让AI拥有企业专属大脑
解决大模型“幻觉”与“知识滞后”痛点,通过RAG技术将企业文档转化为AI可调用的知识资产。
2.1 RAG检索增强生成技术原理
技术架构:文档加载 -> 文本切分 -> 向量化(Embedding) -> 存储 -> 检索(Recall) -> 生成
关键指标:Top-K(召回数量)、Score阈值(相关度过滤)、Rerank(重排序模型)
父子索引(Parent-Child Indexing):小切片检索,大窗口生成,提升上下文连贯性
2.2 Dify知识库构建全流程
数据准备:文本清洗、Markdown格式规范化、去除噪音数据
数据导入与处理:上传文档(PDF/Word/MD)、设置分段规则(自动/自定义)
索引策略配置:高质量索引 vs 经济索引,Embedding模型选择
检索测试:命中率测试、召回内容分析、参数调优
2.3 实战案例:企业级面试宝典助手
场景:基于Datawhale面试经验库,构建招聘面试助手
知识库搭建:导入面试题库,配置混合检索(关键词+向量)
Agent编排:编写Prompt引导AI优先基于知识库回答,无结果时诚实回复
引用归属:在回答中自动标注知识来源文档片段
⚔️ 课堂演练:导入企业员工手册,搭建“新员工入职百事通”
第三讲:Workflow工作流编排——复杂业务逻辑的图形化实现
从简单的对话交互进阶到复杂的业务流程编排,利用Dify的工作流引擎实现标准化、自动化的任务处理。
3.1 Workflow核心节点与逻辑
基础节点:开始(Start)、结束(End)、大模型(LLM)、直接回复(Answer)
逻辑控制:条件分支(If/Else)、代码执行(Code)、参数提取(Parameter Extractor)
数据处理:知识库检索(Knowledge Retrieval)、模板转换(Template Transform)
变量管理:系统变量(System)、用户变量(User)、会话变量(Conversation)
3.2 实战案例:小红书读书卡片生成器
需求拆解:输入书名 -> 联网搜索信息 -> 提取金句 -> 生成HTML卡片代码 -> 渲染展示
节点编排:
1. 输入节点:接收书名
2. LLM节点1(联网):调用智谱GLM-4联网搜索书籍详情
3. LLM节点2(生成):基于书籍信息,生成Bento Grid风格的HTML/CSS代码
4. 代码执行节点(可选):处理字符串格式
5. 结束节点:输出HTML代码,配合Artifacts插件预览
调试技巧:单节点运行测试、Trace日志分析、Token消耗监控
⚔️ 课堂演练:搭建“周报生成器”,输入工作项,自动润色并按格式输出
第四讲:高阶应用与系统集成——打破数据孤岛
探索Dify的高级能力,包括Text2SQL数据库交互、API扩展及多Agent协同,实现与企业现有IT系统的深度融合。
4.1 Text2SQL:让AI像数据分析师一样工作
技术原理:自然语言 -> SQL生成 -> 数据库执行 -> 结果解释
环境准备:MySQL数据库部署(Docker)、示例数据导入
数据源配置:在Dify中添加外部数据工具,连接MySQL
实战演示:输入“查询上个月销售额最高的产品”,AI自动生成SQL并返回图表数据
优化策略:Schema精简、Few-shot示例注入、错误修正机制
4.2 扩展能力与API集成
工具扩展:Google Search、DALL-E 3绘图、Web Scraper爬虫工具使用
API发布:将Dify应用发布为API,供前端网页或飞书/钉钉机器人调用
嵌入式应用:Script标签嵌入企业官网,快速拥有AI客服
多Agent协同(Multi-Agent):路由分发、任务拆解与结果聚合(展望)
4.3 综合实战与课程总结
综合大作业:分组设计并开发一个“企业全能办公助手”
- 包含:公司制度问答(知识库)、周报撰写(工作流)、销售数据查询(Text2SQL)
成果路演:各组展示应用功能、设计思路及落地价值
课程总结:Dify学习路径建议、企业落地避坑指南、AIGC未来趋势
授课老师
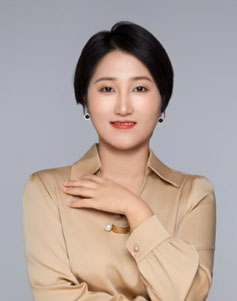
王菡雪 工信部入库AIGC专家讲师
常驻地:武汉
邀请老师授课:13439064501 陈助理